
云手机自动化任务:定时执行、失败重试与人工介入
为什么云手机离不开自动化任务
把一台安卓手机搬到云上,最大的变化不是屏幕变小了,而是它可以7×24 小时不掉线。但如果这台云端设备每天只是安静地待着,它和一台关机的手机没有本质区别。真正决定产出的,是你在睡觉的时候,它在做什么。
签到、打卡、批量上传素材、定时发布内容、巡检页面是否正常、抓取每日数据——这类工作规则清晰、重复度高、出错代价低,天生适合交给自动化任务。而一套靠谱的自动化从来不是「能跑起来就行」,它需要三根支柱:定时执行、失败重试、人工介入。三者缺一个,流程就会在某个凌晨悄悄断掉。
定时执行:让任务在正确的时间点发生
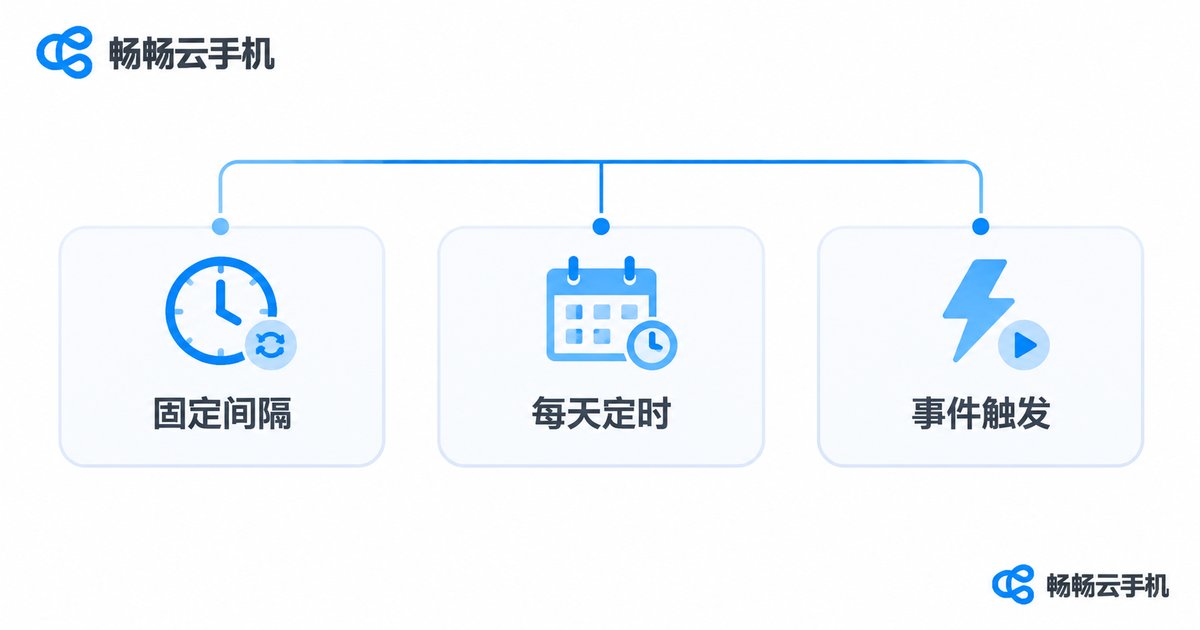
定时执行解决的是「什么时候做」的问题。实际项目里,常见的触发方式有三种,各有各的适用场景:
| 触发方式 | 适合的场景 | 容易踩的坑 |
|---|---|---|
| 固定间隔 | 每 10 分钟巡检一次页面、轮询消息 | 任务耗时超过间隔,造成堆积 |
| 每日定点 | 早八点签到、晚十点汇总数据 | 时区不一致,实际执行时间偏移 |
| 事件触发 | 上一步成功后立即执行下一步 | 上游失败后下游静默不执行 |
最常用的写法是 cron 表达式,几行代码就能表达大部分调度需求:
# 每天早上 8:00 执行一次签到任务
0 8 * * *      task: sign-in

# 每 30 分钟巡检一次页面状态
*/30 * * * *   task: health-check

# 每周一 9:00 汇总上周数据
0 9 * * 1      task: weekly-report
三个高频问题值得提前处理:
一是时区。云端服务器大多数默认 UTC,而你的业务节奏按北京时间设计,两者相差 8 小时。部署前先确认调度器用的是哪个时区,否则签到任务会在下午四点准时执行。
二是任务耗时。如果一次任务要跑 12 分钟,而间隔设成 10 分钟,任务会不断叠加,最后把设备资源吃光。给每个任务设一个最大执行时长,超时就判为失败并进入重试流程,比让它无限挂着更安全。
三是并发上限。同一台云手机在某个时刻只能专心做一件事。批量任务要排队,不要同时往一台设备上塞五个脚本。
失败重试:把偶发错误挡在人工之前
云手机任务失败的原因,八成不是程序写错了,而是环境在抖动:网络瞬断、页面元素加载慢了半秒、突然弹出验证码、设备内存不足被后台清理。这类问题重跑一次往往就恢复正常。
所以第一步不是加大重试次数,而是把错误分成能重试和不能重试两类:
| 错误类型 | 典型表现 | 建议动作 |
|---|---|---|
| 可重试 | 网络超时、元素未找到、页面白屏 | 退避后自动重试,最多 3 次 |
| 有条件重试 | 接口限流、登录态过期 | 先等待或重新登录,再重试 1 次 |
| 不可重试 | 账号被限制、需要人工验证、数据格式错误 | 立即停止,转入人工介入 |
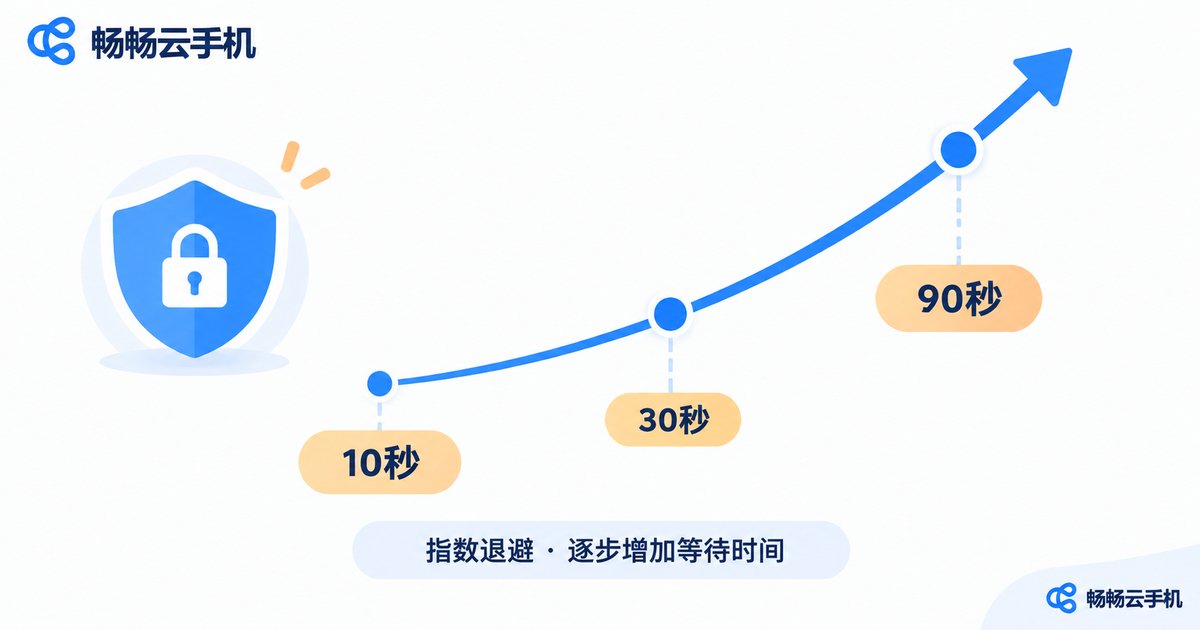
重试也不能是无脑循环。推荐使用指数退避:第一次失败等 10 秒,第二次等 30 秒,第三次等 90 秒。这样既给环境恢复的时间,也不会在短时间内把同一台设备打到限流。
retry:
  max_attempts: 3
  backoff: exponential      # 10s -> 30s -> 90s
  retry_on:
    - NETWORK_TIMEOUT
    - ELEMENT_NOT_FOUND
  give_up_on:
    - ACCOUNT_BLOCKED
    - CAPTCHA_REQUIRED
还有一个容易被忽略的点:幂等性。一个「提交表单」的任务,如果第一次其实已经成功了,只是回执没收到,盲目重试就会变成重复提交。凡是写操作,重试前先查一次状态,确认没成功再执行——这一步能省掉大量事后补数据的麻烦。
人工介入:该人来的时候一定要叫得醒
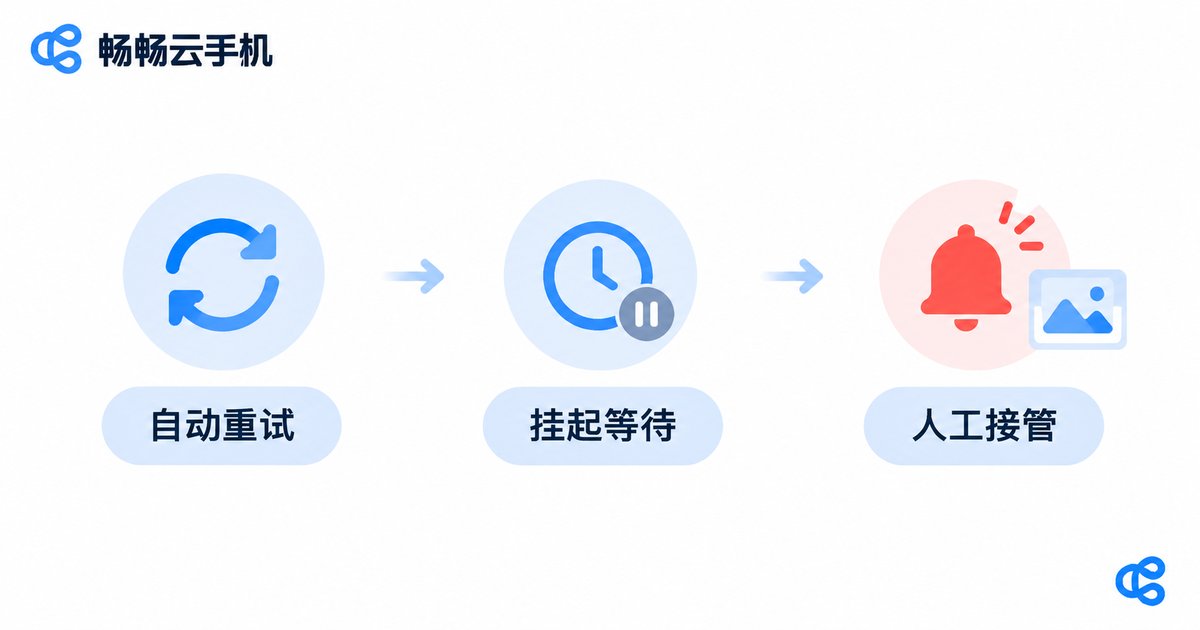
自动化的目标从来不是「消灭人」,而是「把人放在最需要的位置」。当重试次数耗尽,或者遇到不可自动修复的错误,系统应该做三件事:停下来、留证据、叫醒人。
停下来,指的是任务进入挂起状态,而不是继续往同一台设备上堆失败请求。留证据,指的是保存失败时刻的截图、页面结构、当前步骤编号和最近几条日志——这些信息决定了人工介入是花两分钟还是花两小时。叫醒人,指的是把告警推到真正会处理的人手上,并且带上足够上下文。
一个实用的分级策略是这样的:
| 等级 | 触发条件 | 谁来看 |
|---|---|---|
| 提示 | 单次失败,重试成功 | 无需处理,仅记日志 |
| 警告 | 同一任务连续失败 3 次 | 值班人员次日复盘 |
| 告警 | 同一设备当天失败超过阈值 | 即时通知,人工接管 |
| 熔断 | 批量设备同时失败 | 自动暂停全部同类任务 |
最后一级「熔断」特别值得加上。当十台设备在同一分钟里全部报同样的错,大概率不是设备问题,而是页面改版或账号策略调整——这时候最该做的是整体刹车,而不是继续重试一千次。
在畅畅云手机上落地这套流程
畅畅云手机(ccloudphone)把安卓设备放在云端运行,本地电脑关机、断网都不影响任务继续跑。对于需要长时间值守的自动化场景,有几点比较实用:
一是常驻在线。定时任务挂在云端设备上,不会因为你合上笔记本而漏跑,早八点的签到照样准点执行。
二是批量管理。多台设备统一纳管,同一套任务可以下发到设备组,不用一台一台手动配置。
三是开放接口。可以把任务调度接到你自己的系统里,成功、失败、耗时的结果回传出来,方便做统一的重试与告警。
四是过程留存。运行过程中的画面与日志可以回看,人工介入时能直接看到失败那一刻的现场,不用靠猜。
具体功能规格与接入方式,建议以官网说明为准,按自己的任务量选择合适的配置。
常见问题
Q:定时任务到点了却没执行,一般是什么原因?
先看时区设置,这是最常见的原因;其次确认调度器是否处于暂停状态;最后检查上一次任务是否还没结束、占着同一台设备。按这个顺序排查,九成问题能在五分钟内定位。
Q:重试 3 次还是失败,是不是该把次数调到 10 次?
一般不建议。重试的意义是覆盖环境抖动,而抖动通常一两次就恢复了。连续失败 3 次以上,往往意味着结构性问题,比如页面改版或账号状态异常,继续重试只会浪费时间并放大风险。这时候更该做的是停下来告警。
Q:人工介入会不会太频繁,反而比手动更累?
如果告警特别多,通常是错误分级没做好:把所有失败都设成即时告警,人自然被淹没。把「重试成功」的失败降级为日志记录,只对连续失败和批量失败推送通知,告警量会明显下降。
Q:云手机跑自动化,和本地手机挂着脚本有什么区别?
核心差别在稳定性。本地手机会锁屏、会断网、会被其他应用抢占资源,任务中断后往往没人知道。云端设备保持常驻运行,配合日志和告警,失败能被记录、能被重试、能被人工接住,这才是可长期运行的基础。
Q:整套流程大概需要多少工作量才能搭起来?
如果只做单机单任务,一部 cron 加一个重试开关就够了。真正需要投入的是错误分级、告警渠道和幂等校验这三块——它们不决定任务能不能跑,却决定这套自动化能不能安心放着不管。


