
云手机任务失败重试机制:效率提升与风险控制思路
为什么云手机上的任务总是莫名其妙地失败
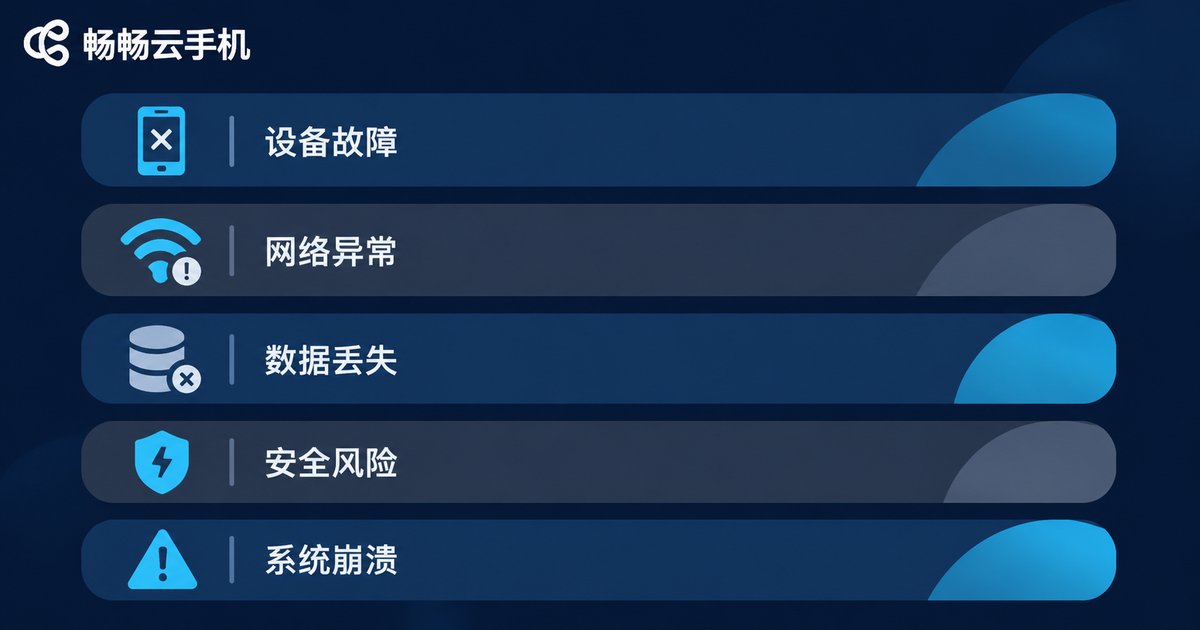
在云手机上跑脚本、跑批量任务的人,几乎都遇到过这样的场景:一批任务发下去,第二天早上看结果,成功率只有七八成。剩下的任务不是没执行,而是执行到一半失败了。仔细看日志会发现,失败的原因其实就那么几类:网络抖动导致请求超时,实例负载过高导致脚本卡死,目标应用的风控临时拦截,以及调度层在分配实例时出现的短暂资源不足。
这些失败里,大部分并不是任务本身不可行,而是这一次运气不好。如果每个失败都靠人工补跑,人力和时间成本会迅速膨胀。这也是为什么,一套设计合理的任务失败重试机制,基本决定了云手机规模化使用的效率上限。
先分类,再重试:不是所有失败都值得重试
很多团队一上来就给所有任务加一个失败重试三次,结果反而把问题放大了。正确的第一步是给失败分类,不同类别走不同的处理策略。
| 失败类型 | 典型表现 | 建议策略 |
|---|---|---|
| 瞬时网络错误 | 连接超时、域名解析失败 | 立即重试,采用指数退避 |
| 实例资源不足 | 启动超时、内存告警、脚本无响应 | 更换实例后重试 |
| 脚本逻辑异常 | 页面元素找不到、页面结构变化 | 不自动重试,转人工排查 |
| 风控拦截 | 出现验证码、限流提示 | 拉长间隔后重试,或分批放量 |
| 幂等冲突 | 重复提交被服务端拒绝 | 不重试,直接视为已完成 |
这张表的价值在于:它把值得机器重试的失败和需要人介入的失败分开了。前者交给程序自动处理,后者进入告警队列,两边都不浪费资源。
重试机制的四个核心要素
一、幂等标识。重试最大的隐患是同一个动作被执行了两次。每个任务在创建时就应当带一个唯一的业务标识,服务端据此判断是否已经处理过。没有幂等设计,重试就等于在制造重复数据。
二、最大重试次数。重试不是越多越好。一般建议单任务上限三到五次,超过就判定为持续性故障,直接进入死信队列。无限重试会让一个坏任务长期占用实例,拖慢整批任务。
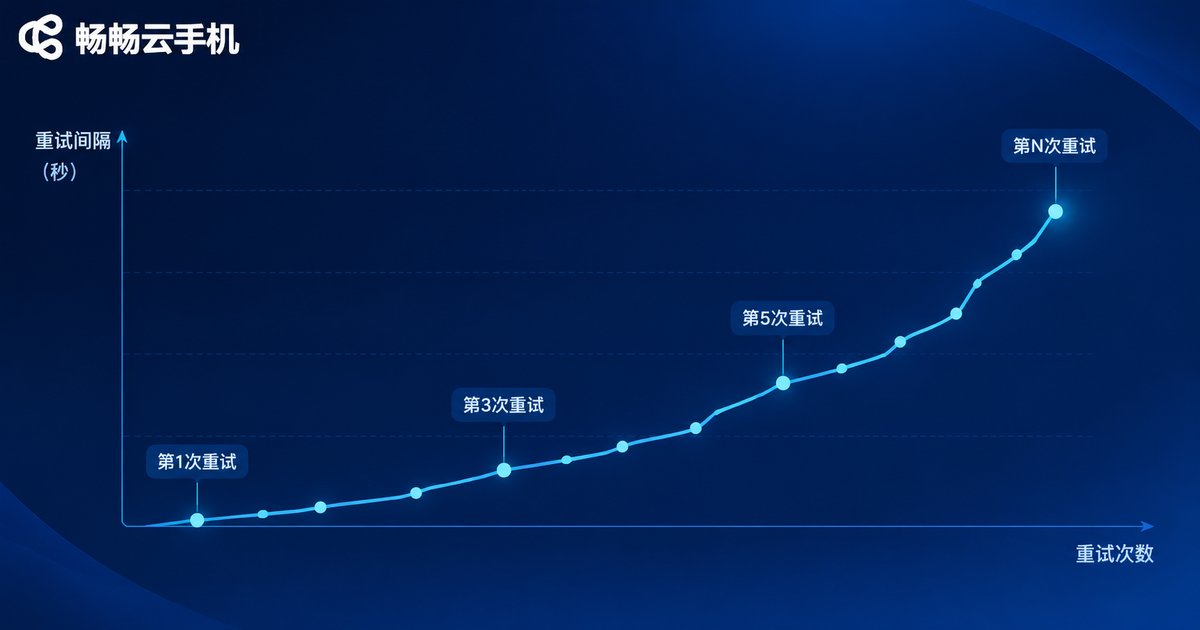
三、退避策略。失败后立刻再试一次,往往还是失败,因为导致失败的条件还没恢复。常见的做法是指数退避加随机抖动:第一次等两秒,第二次等四秒,第三次等八秒,再叠加一个随机的浮动量,避免大量任务在同一时刻集中重试,把压力重新堆到目标服务上。
四、可观测性。每次重试都要留下记录:第几次重试、原始错误码、耗时、所在实例。没有这些数据,你永远不知道自己是在修问题,还是在掩盖问题。
效率提升:让重试更快,也更省
指数退避要配合抖动。纯指数退避会让所有失败任务在相同的时间点醒来,形成新的流量尖峰。加上百分之二十到三十的随机抖动,可以把重试流量摊平,整体耗时反而更短。
并发和限流要配套。重试任务的优先级通常低于新任务,可以放进独立的低优先级队列,并设置并发上限。这样即使某一时刻失败率飙升,新任务也不会被拖住。
分层队列比单一队列更稳。把任务分成快速重试层、延迟重试层和人工处理层,各层用不同的消费速度。快失败快回滚,慢失败慢慢修,整体吞吐会更平滑。
失败快照能大幅降低排查成本。任务失败瞬间截一张屏,并记录关键步骤的日志,比事后凭时间戳去翻录像高效得多。很多逻辑类失败,看到截图就能立刻判断原因。
风险控制:重试最容易踩的三个坑
坑一:重复执行业务动作。转发一条消息、提交一次表单、领取一次奖励,这类动作如果因为没有幂等标识而被重试两次,就会直接造成业务错误。处理原则是:写操作必须带幂等键,读操作可以放心重试。
坑二:重试放大风控风险。当目标应用因为频率过高而拦截时,立刻重试只会让账号状态更差。正确的做法是先识别出这类错误码,然后拉长间隔、降低并发、分批放量,而不是死磕次数。
坑三:重试掩盖真实故障。如果一批任务的失败率突然从百分之十跳到百分之五十,这不是重试能解决的问题,而是环境或脚本变了。应当设置熔断阈值:在时间窗口内失败率超过阈值时,暂停自动重试并触发告警,让团队先看清楚发生了什么。
一套可以直接落地的参数模板
下面这份配置覆盖了绝大多数云手机批量任务场景,可以直接作为起点,再根据业务容忍度微调。
retry_policy = {
  'max_attempts': 3,
  'base_delay': 2,
  'backoff': 'exponential',
  'jitter_ratio': 0.3,
  'timeout_per_attempt': 60,
  'retry_on': ['network_timeout', 'instance_busy'],
  'no_retry_on': ['script_error', 'risk_control', 'idempotent_conflict'],
  'circuit_breaker': {
    'window_seconds': 300,
    'failure_rate_threshold': 0.5
  }
}这份配置的关键点有三个:只对瞬时类错误自动重试,脚本和风控类错误一律不盲目重试,失败率过高时自动熔断。先保证不出大错,再追求高成功率。
把重试机制跑稳,底层环境同样关键
再好的重试逻辑,如果底层实例本身频繁掉线、启动缓慢,也只是在反复消耗重试次数。因此在设计机制的同时,选择稳定的云手机环境同样重要。
畅畅云手机(ccloudphone)面向批量任务场景提供了稳定运行的云端实例,支持多实例统一管理与批量操作,任务状态和执行结果可以在管理端集中查看。对于需要长期运行批量脚本的团队来说,这种可观测、可批量管理的环境,能让重试机制真正发挥作用——因为大部分失败会被挡在环境层面,而不是留给业务逻辑去兜底。
落地时可以按这个顺序推进:先记录并统计失败类型,再配置分类重试策略,最后用熔断和告警兜住异常峰值。三步做完,成功率通常会有明显提升,而人工补跑的压力会大幅下降。
常见问题
Q:重试次数设置多少次比较合适?
一般建议三到五次。次数太少会让偶发抖动直接变成失败,次数太多则会延长单个任务的占用时间。更好的做法是按失败类型区分:瞬时错误给三次机会,资源不足类先换实例再给两次,逻辑错误一次都不重试。
Q:指数退避和固定间隔重试有什么区别?
固定间隔重试会在同一时间点制造新的流量高峰,尤其当大量任务同时失败时更明显。指数退避让每次等待时间递增,配合随机抖动,可以把重试流量打散,整体对目标服务更友好。
Q:什么情况下应该停止自动重试?
三种情况建议直接停止:一是业务动作无法保证幂等,二是失败原因是风控拦截,三是时间窗口内失败率超过阈值。前两种停止是为了避免制造错误,第三种停止是为了让团队先排查环境。
Q:重试日志应该记录哪些字段?
至少包括任务标识、第几次尝试、原始错误码、每次尝试的耗时、所在实例编号,以及失败瞬间的截图。字段不用多,但这几项能覆盖绝大多数排查场景。
Q:为什么换了稳定的云手机环境,任务成功率还是上不去?
环境只解决了运行稳定性,脚本逻辑、页面结构变化、业务频次控制仍然需要自己处理。建议先把失败原因统计出来,看看占比最高的是哪一类,再针对性优化,而不是一味增加重试次数。


