
云手机运行状态怎么看:日常巡检清单与异常判断方法
为什么云手机需要日常巡检
云手机和真机最大的区别是:它没有实体机身,你看不见风扇转速,也摸不到温度。出问题时,用户往往只感觉到“画面卡了一下”“点了没反应”“突然掉线了”。
而绝大多数云手机故障并不是瞬间发生的。它们更像慢性的:CPU 占用一点点爬高、内存只涨不降、网络丢包率悄悄从 0.1% 变成 3%,最后在某一次集中操作里彻底暴露。
日常巡检的意义,就是在用户抱怨之前,从几个数字的趋势里提前看到问题。每天几分钟的观察,通常比事后花半小时翻日志更划算。
五项核心指标:听懂云手机在说什么
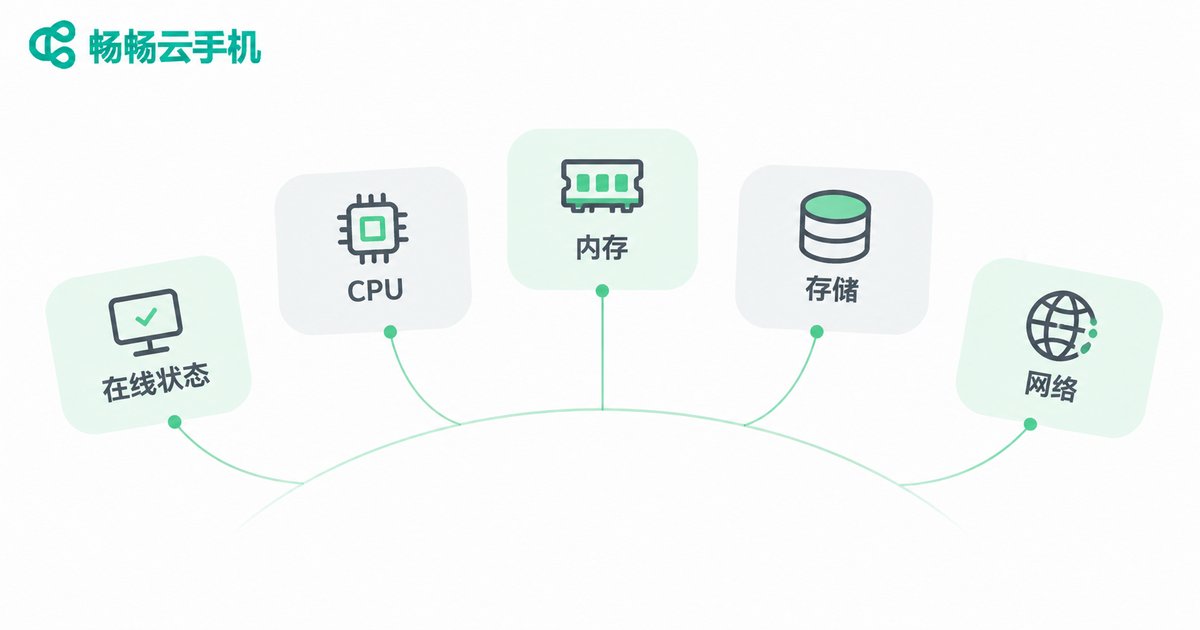
不必成为运维专家,记住下面五项就够了。它们基本覆盖了云手机 90% 以上的常见问题。
- 在线状态与心跳:实例是否在线、连接是否稳定。这是所有判断的前提,离线状态下其他指标都失去意义。
- CPU 使用率:长时间高于 80%,通常意味着算力不够,表现为画面卡顿、操作掉帧、应用响应慢。
- 内存占用:健康的状态是“涨落有起伏”。如果持续上升且从不回落,多半是应用内存泄漏,早晚会闪退。
- 存储剩余空间:低于 10% 时要警惕,应用启动变慢、日志写入失败、缓存无法落地都会接踵而来。
- 网络延迟与丢包:延迟决定操作手感,丢包决定画面是否花屏、是否会突然断连。
把五项放在一起看,你就能快速判断问题出在算力、内存,还是网络。这是后面所有异常判断的基础。
日常巡检清单:照着做就行
巡检不是把所有指标都看一遍,而是按节奏分层。下面这份清单按频率分三档,可以根据设备规模自行增减。
| 频率 | 检查项 | 正常标准 |
|---|---|---|
| 每班开始 | 实例在线率、账号是否可正常登录 | 全部在线,无异常退出记录 |
| 每班开始 | 应用是否正常启动、画面是否正常出图 | 启动在预期时间内,画面无黑屏、无花屏 |
| 每 2 小时 | 抽查 CPU 与内存占用 | CPU 低于 80%,内存无明显单边上涨 |
| 每 2 小时 | 查看网络延迟与丢包 | 延迟稳定,丢包接近 0 |
| 每日一次 | 存储剩余空间 | 剩余空间大于 15% |
| 每周一次 | 资源趋势曲线、告警记录复盘 | 无持续恶化的趋势线 |
| 每周一次 | 应用版本、系统镜像是否一致 | 同批次实例版本统一 |
巡检最重要的不是“看”,而是留下来。建议用一个简单表格记录每次的数值,哪怕只记 CPU、内存和延迟三列,一周后你就能看出趋势。趋势比单点数值有用得多。
异常判断:现象、原因与第一步动作
知道看什么之后,下一步是知道“看到了该怎么办”。下面这张对照表覆盖了最常遇到的几类现象。
| 现象 | 大概率原因 | 第一步动作 |
|---|---|---|
| 画面卡顿、操作掉帧 | CPU 长期打满,算力不足 | 先关闭后台高占用应用,再评估是否需要更高配置 |
| 应用反复闪退 | 内存占用顶到上限 | 重启应用并观察内存曲线是否再次单边上涨 |
| 黑屏、无画面但实例在线 | 显示输出或推流进程异常 | 尝试重连实例,无效则重启实例 |
| 频繁断连、连接中断 | 网络丢包升高,或本地网络波动 | 先确认本地网络,再切换接入线路或节点 |
| 操作延迟明显变大 | 网络往返延迟升高 | 对比不同节点延迟,优先就近接入 |
| 应用启动越来越慢 | 存储空间不足、缓存堆积 | 清理缓存与无用文件,释放存储空间 |
| 实例无法开机或频繁重启 | 系统异常或资源调度失败 | 查看实例状态说明,必要时重装或重建实例 |
这里有个实用原则:先判断是“单台问题”还是“批量问题”。一台异常,优先查这台实例;如果一批同时异常,优先查网络链路、镜像版本或整体资源配置。方向对了,排查时间能省一大半。
把巡检变成习惯的三个小技巧
第一,固定巡检时间点。比如每班开始前 10 分钟、午休前、下班交接前各一次。固定时间点比“想起来才看”有效得多。
第二,设置合理的告警阈值。CPU 连续 10 分钟高于 80%、内存连续 30 分钟上涨、丢包率超过 1%,都值得提醒。阈值不要定得太敏感,否则告警会被忽略。
第三,交接必须有记录。把当班的异常现象、处理动作、结果写清楚。云手机是长时间运行的,一次没记录清楚的异常,往往要重复排查好几遍。
用畅畅云手机(ccloudphone)做巡检更省心
如果不想在每台实例上手动翻指标,可以选择把巡检动作集中起来。畅畅云手机(ccloudphone)提供云端 Android 实例,通过网页或客户端即可接入管理,实例运行状态与资源占用可以在控制台中集中查看,多台实例的批量操作也无需逐台切换。
对于需要长时间稳定运行的场景,把实例托管在云端、配合固定节奏的巡检记录,通常比人手一台真机更容易管住风险。具体可用配置与接入方式,以官网说明为准,建议先按小规模试用,确认与自身业务的适配度。
常见问题
Q:云手机看运行状态,最少要看哪几项?
如果只看三项,建议看 CPU 使用率、内存占用趋势和网络延迟丢包。这三项基本能覆盖卡顿、闪退和断连三大类问题。
Q:CPU 使用率忽高忽低正常吗?
正常。短时间波动说明业务在正常调度资源,真正需要关注的是“长时间贴着高位不下来”,那才是算力不足的信号。
Q:内存占用高就一定要升级配置吗?
不一定。先看是否持续单边上涨且不回落,这更像内存泄漏,重启应用或清理缓存往往就能缓解。如果重启后很快又满,再考虑调整配置。
Q:只卡一台,需要大范围排查吗?
不需要。单台异常优先检查该实例的进程、存储和资源占用;批量异常才需要往网络链路、镜像版本和整体配置方向排查。
Q:巡检多久做一次比较合适?
班前一次完整巡检,班中每 2 小时抽查核心指标,每日看一次存储,每周复盘一次趋势曲线。这个节奏对大多数场景已经够用。
Q:没有专业监控工具也能巡检吗?
可以。用控制台提供的实例状态与资源信息,配合一张简单的记录表,坚持记录趋势,就能发现绝大部分早期问题。


