
云手机群控的异常自愈机制:掉线重连、进程守护、卡死重启怎么配
为什么群控规模一大,自愈就成了刚需?
只管三五台云手机时,掉线了手动重连、应用崩了手动打开,都算不上麻烦。可一旦规模上到几十台甚至上百台,网络抖动、应用闪退、界面卡死这些单设备上的小概率事件,就会每天成批出现:夜里跑批量任务时一台实例悄悄掉线,第二天早上才发现,一整晚的算力就白跑了。
所谓异常自愈机制,就是让系统在无人干预的情况下自动完成“发现问题—执行恢复—确认结果”的闭环。它通常由三道防线组成:掉线重连守网络层、进程守护守应用层、卡死重启守系统层。下面逐个拆解怎么配。
三道防线总览:先检测、再恢复、后验证
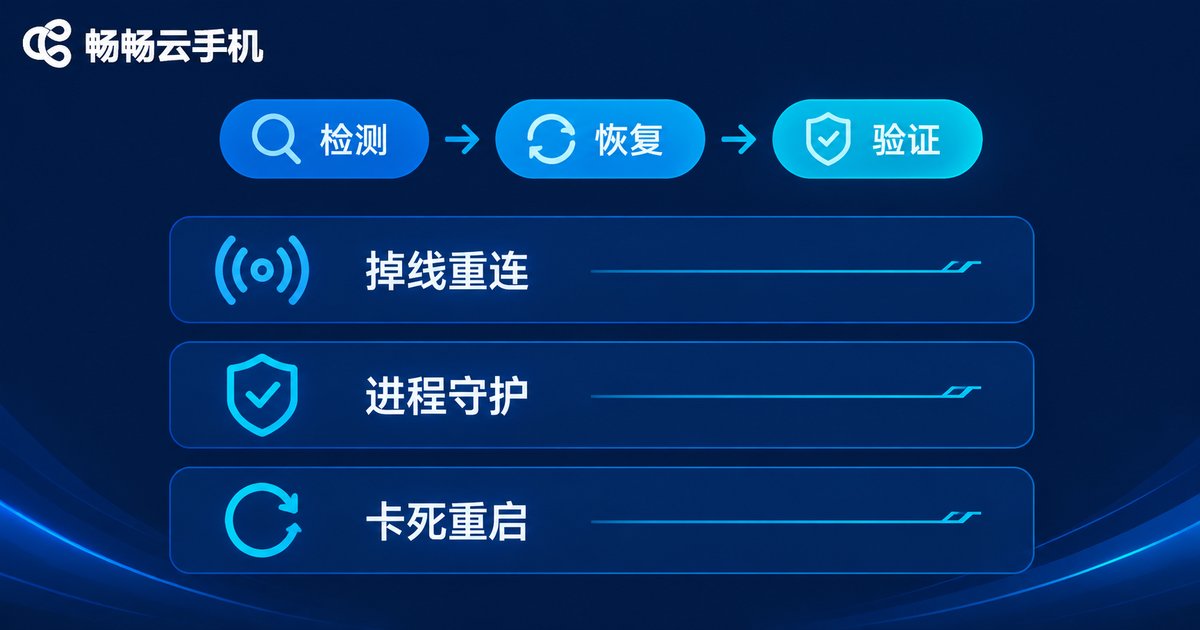
一套靠谱的自愈流程,核心不是“重启”这个动作,而是前面的检测和后面的验证:检测决定你能不能第一时间发现异常,验证决定恢复动作是不是真的生效。三道防线各司其职:
| 防线 | 针对的异常 | 典型恢复动作 |
|---|---|---|
| 掉线重连 | 网络中断、连接超时 | 心跳探测+指数退避重连 |
| 进程守护 | 应用闪退、被系统回收 | 看门狗检测+自动拉起 |
| 卡死重启 | 界面无响应、资源耗尽 | 分级重启,软重启优先 |
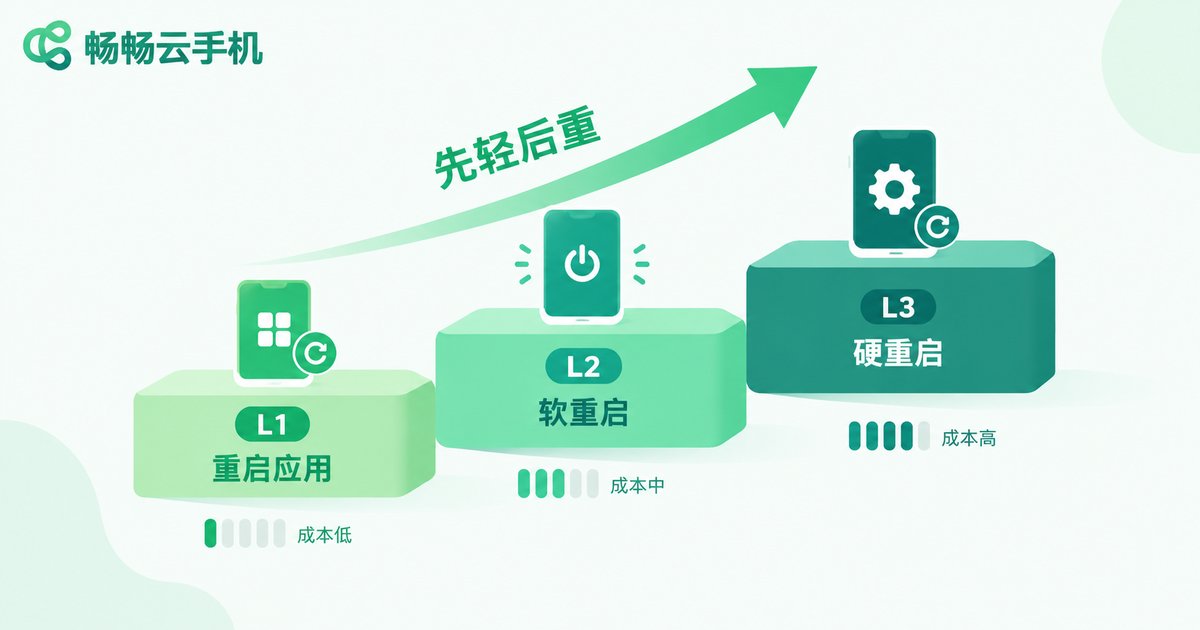
配置时坚持先轻后重:能重连解决的不拉进程,能拉进程解决的不重启整机,能软重启的不硬重启。每升一级恢复动作,都意味着更长的中断时间和更大的状态丢失风险。
第一道防线:掉线重连怎么配
掉线是群控场景里最高频的异常,配置重点抓三个参数:
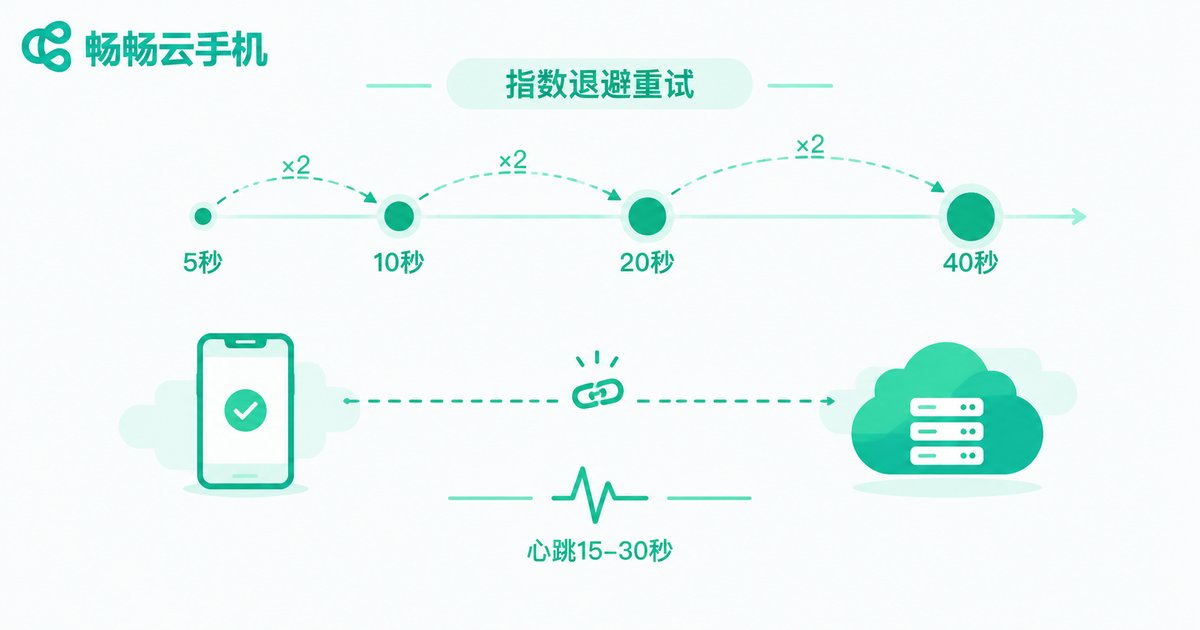
1. 心跳间隔。心跳用于主动探测连接是否存活,一般设 15~30 秒。太短会制造大量无效流量,太长则发现太晚。建议配合超时判定:连续 2~3 个心跳无响应才判定掉线,避免单次网络抖动造成误判。
2. 重试退避策略。不要用固定间隔死磕,推荐指数退避:从 5 秒起步,每次失败翻倍(5s→10s→20s→40s),并设上限(如 5 分钟)。网络短暂波动时能快速恢复,长时间断网时也不会打爆服务端。
3. 会话恢复。重连成功只是第一步,关键是让实例回到掉线前的任务状态:任务队列是否持久化、断点位置有没有记录、重连后是续跑还是重跑。理想状态是任务级断点续传,至少也要做到实例级状态快照。
第二道防线:进程守护怎么配
进程守护解决的是“应用没了”:目标 App 闪退、被系统内存回收杀掉、或者启动失败。配置要点有三:
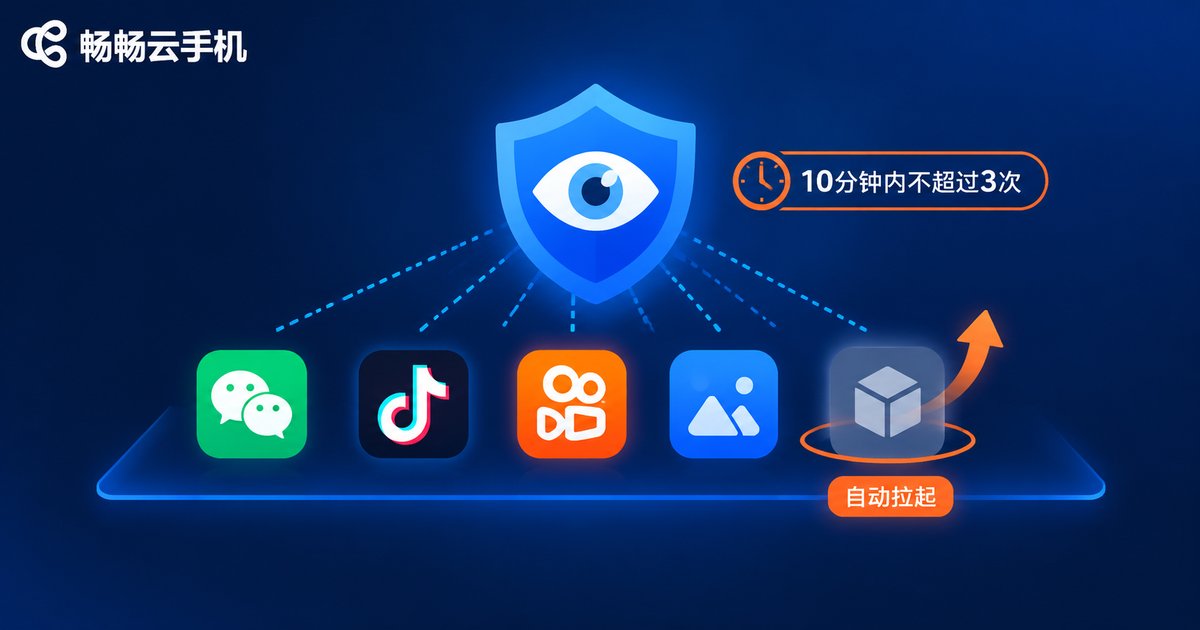
1. 看门狗检测。把关键应用加入守护名单,按固定周期(10~30 秒)检查其是否存活。建议用包名+前台状态双重校验,避免应用正常后台休眠时被误判为崩溃。
2. 拉起策略与上限。发现进程消失,先常规拉起(通过启动意图重新打开);若短时间内反复崩溃(如 10 分钟内超过 3 次),说明不是偶发问题,应逐级升级:清理缓存→重置应用数据→重启实例。务必设置拉起次数上限并触发告警,防止陷入“崩溃—拉起—再崩溃”的死循环。
3. 拉起后验证。应用拉起不等于恢复完成,要确认它真的进入可用状态:有没有停在登录页、有没有弹更新窗、有没有卡在加载页。把“验证通过”作为恢复闭环的终点。
第三道防线:卡死重启怎么配
卡死最棘手:进程还活着,界面却点不动、任务不推进,常见诱因是应用无响应(ANR)、内存耗尽、渲染异常。思路是先识别、再分级重启:
1. 卡死识别。别只盯 CPU 占用——高占用可能只是正常运算。更可靠的信号组合是:界面长时间无新帧+输入事件无响应+任务进度持续不变,三者同时满足并持续 3~5 分钟,才判定为真卡死。
2. 分级重启。确认卡死后,按代价从小到大执行:
| 级别 | 动作 | 适用场景 | 代价 |
|---|---|---|---|
| L1 | 重启目标应用 | 单个应用卡死 | 低,其他任务不受影响 |
| L2 | 软重启实例 | 多个应用同时异常 | 中,部分实例状态丢失 |
| L3 | 硬重启实例 | 系统级卡死、软重启无效 | 高,耗时最长 |
3. 重启前存现场、重启后设上限。执行重启前尽量记录任务进度和关键页面状态,重启后按记录恢复;同时给重启频率设上限——一台实例若一天内反复触发 L3,说明它本身有问题(资源不足或镜像异常),应标记出来人工介入,而不是无限重启。
核心参数速查表:三道防线一次配齐
把关键参数汇总成一张表,可直接当配置清单用(具体数值按业务容忍度微调):
| 模块 | 参数 | 建议值 | 说明 |
|---|---|---|---|
| 掉线重连 | 心跳间隔 | 15~30 秒 | 连续 2~3 次无响应才判定掉线 |
| 掉线重连 | 重试退避 | 5 秒起指数递增,上限 5 分钟 | 避免断网期间打爆服务端 |
| 进程守护 | 检测周期 | 10~30 秒 | 包名+前台状态双重校验 |
| 进程守护 | 拉起上限 | 10 分钟内不超过 3 次 | 超限升级处理并告警 |
| 卡死重启 | 卡死判定 | 三信号同时满足,持续 3~5 分钟 | 无新帧+输入无响应+进度不变 |
| 卡死重启 | 重启策略 | L1→L2→L3 逐级升级 | 先轻后重,重启前保存现场 |
落地建议:让自愈机制真正兜得住
参数配好只是起点,想让自愈在真实业务里稳定发挥作用,还有四件事值得做:
1. 灰度验证。新配置先在少量实例上跑几天,对比自愈触发率、恢复成功率、平均恢复时长,确认没有误判(比如把正常休眠当成卡死)再全量推开。
2. 全程留痕。每次异常检测和恢复动作都记日志:什么时间、哪台实例、什么异常、做了什么、结果如何。日志既是排查依据,也是后续调参的数据来源。
3. 兜底告警。自愈不是万能的:重连次数超限、拉起陷入死循环、重启频率异常时,要及时通知人工。自愈负责 95% 的常规异常,剩下 5% 交给人和流程。
4. 定期演练。定期主动制造异常(断网、强制停止应用),验证自愈链路仍然有效,避免真出事时才发现配置早已失效。
为什么推荐用畅畅云手机跑群控任务
自愈机制解决的是“异常发生之后怎么办”,而选一个稳定的云手机平台,能从源头减少异常发生的概率。畅畅云手机(ccloudphone)的实例运行在云端机房,网络与供电环境远比本地设备稳定,天然适合长时间挂机和批量任务场景;配合群控批量操作,上面这套“掉线重连+进程守护+卡死重启”策略可以统一应用到全部实例,无需逐台手动维护。具体功能与套餐信息,建议直接访问畅畅云手机官网查看,以官方页面为准。
常见问题
Q:心跳间隔设得越短,掉线发现得越快,是不是越好?
不是。心跳过短会显著增加无效流量和服务端压力,还容易把正常网络抖动误判为掉线,触发不必要的重连。15~30 秒配合连续多次判定更稳妥。
Q:应用被拉起后又立刻崩溃、反复循环怎么办?
说明崩溃不是偶发的。设置拉起次数上限(如 10 分钟内不超过 3 次),超限后逐级升级:清缓存、重置数据、重启实例,并触发告警让人工排查根因。
Q:怎么区分“应用真卡死”和“任务本来就慢”?
单看 CPU 或进度都容易误判。用组合信号:界面长时间无新帧+输入无响应+进度持续不变,三者同时满足并持续数分钟再判定,并在灰度阶段重点观察误判率。
Q:软重启和硬重启怎么选?
默认先软重启:代价小、速度快,能解决大部分系统界面层异常;只有软重启无效或系统级卡死才用硬重启。能低不高,每次升级都意味着更长中断。
Q:自愈机制配好了,还需要人工值守吗?
需要,但角色变了。人工重点转向三件事:盯告警(处理自愈搞不定的少数情况)、看日志(发现误判与调参空间)、定期演练(确保链路持续有效)。


