
云手机自动化中的异常处理:应用崩溃检测与实例自动重启配置
为什么云手机自动化必须做好异常处理
当你把挂机、批量操作等任务交给云手机自动运行时,最大的风险不是任务复杂,而是无人值守时的静默失败。脚本在凌晨让应用闪退,如果没有检测和自动恢复机制,可能到第二天早上你才发现整晚任务全部白跑,浪费的时间成本远超想象。
异常处理的核心思路只有两步:第一时间发现异常,然后按预案自动恢复。本文带你搭建一套“检测—重启—告警”的完整闭环,让云手机里的自动化任务真正做到7×24小时稳定运行。
云手机环境中常见的异常类型
动手配置之前,先弄清楚自动化任务通常会遇到哪些异常:
应用闪退:进程直接消失,多由内存不足、代码缺陷或兼容性问题引起;应用无响应(ANR):进程还在,但界面卡死点不动;任务假死:界面看似正常,进度却长时间不变;网络异常:请求超时导致任务卡在某个步骤;实例级故障:整个云手机实例卡死,连ADB命令都无响应。
不同异常需要不同的检测手段和恢复动作,下面逐一展开。
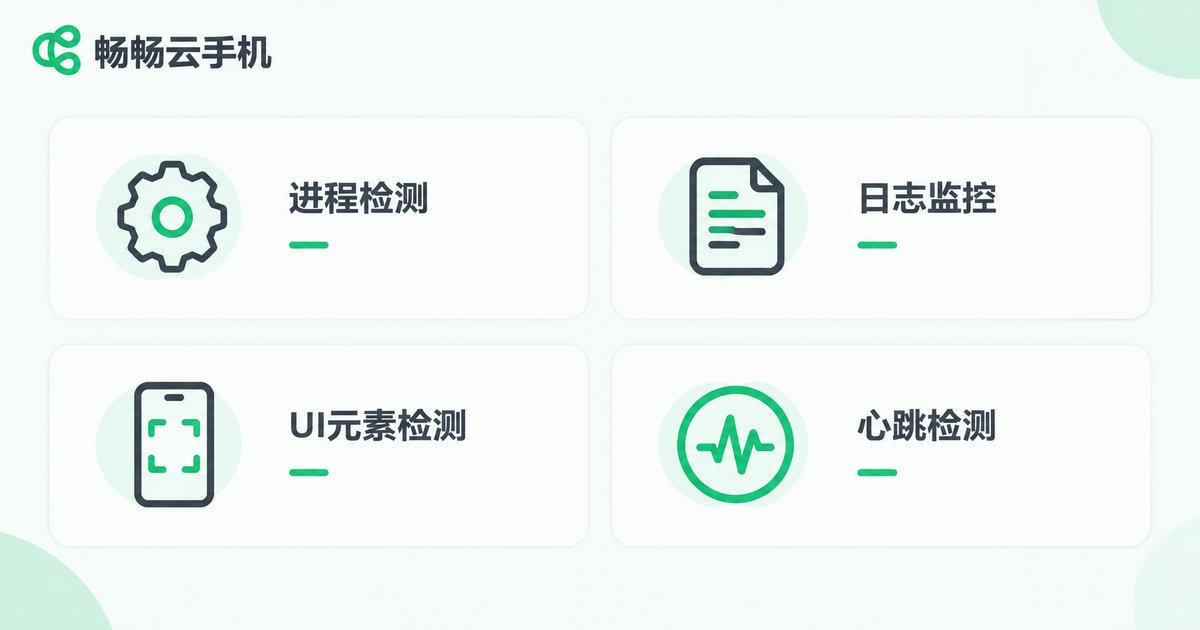
四种常用的崩溃检测方法
1. 进程检测:最直接的方式,通过 adb shell pidof 包名 检查目标应用进程是否存在,进程消失即判定崩溃。实现简单、开销极低,适合作为所有任务的基础监控。
2. 日志监控:持续监听logcat输出,捕获 FATAL EXCEPTION 等崩溃关键字。它不仅能发现崩溃,还能拿到崩溃堆栈,方便定位原因,适合稳定性要求高的场景。
3. UI元素检测:定时截屏或用UI自动化框架检查关键元素是否还在预期位置。进程活着但白屏、卡死、被弹窗遮挡的情况,只有这种方式能发现。
4. 心跳检测:让任务脚本每隔一段时间上报一次进度计数,监控端发现计数长时间不变就判定假死。它检测的不是“应用是否活着”,而是“任务是否在推进”,常能发现前三种方法漏掉的问题。
| 检测方式 | 能发现的问题 | 实现难度 | 适用场景 |
|---|---|---|---|
| 进程检测 | 闪退、进程被杀 | 低 | 所有任务的基础监控 |
| 日志监控 | 崩溃堆栈、ANR | 中 | 需要定位崩溃原因 |
| UI元素检测 | 白屏、卡死、弹窗遮挡 | 中 | 有明确界面特征的任务 |
| 心跳检测 | 任务假死、进度停滞 | 低 | 长时间批处理任务 |
实践中建议至少组合两种检测方式,例如“进程检测+心跳检测”,用极低成本覆盖绝大多数故障。
实例自动重启的分层策略
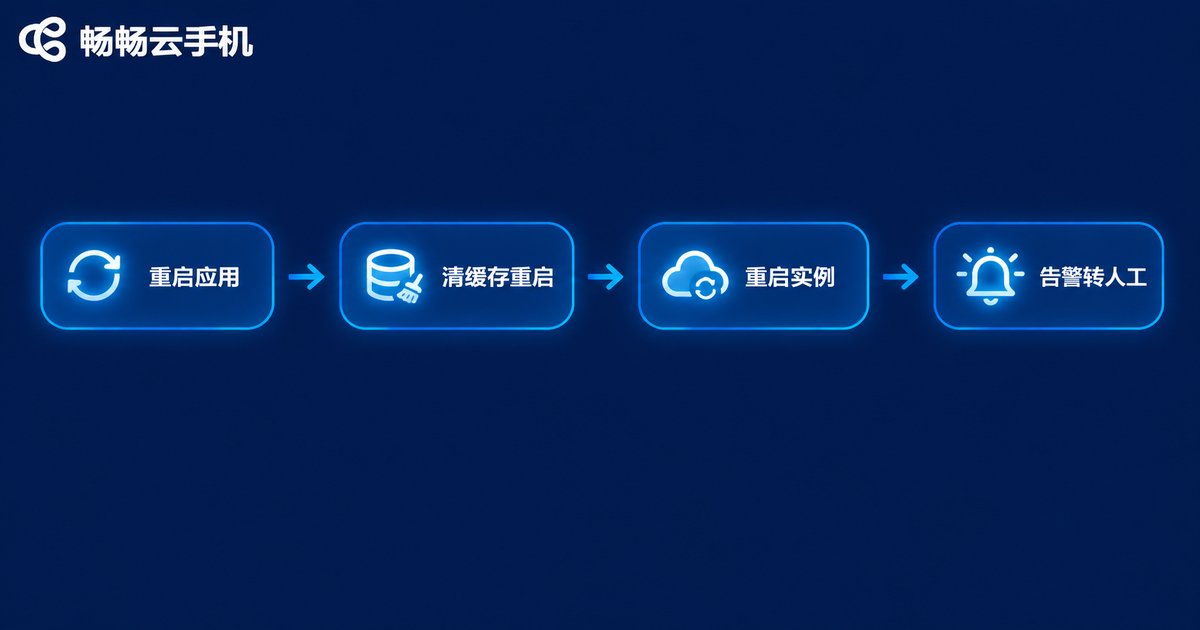
检测到异常后,不建议一上来就重启整个实例,推荐按影响范围从小到大分层处理、逐级升级:
第一层:重启应用。强制停止后重新拉起,适用于偶发闪退,恢复最快、副作用最小。第二层:清缓存后重启。应用反复崩溃多半是缓存或本地数据损坏,清缓存常能解决。第三层:重启云手机实例。应用怎么重启都没用、ADB也无响应时,说明是系统级卡死,直接重启实例。第四层:告警并转人工。达到最大重试次数后停止自动操作,通知人工介入,避免陷入“崩溃—重启—再崩溃”的死循环。
| 处理层级 | 具体操作 | 适用情况 |
|---|---|---|
| 第一层 | 重启应用 | 偶发闪退 |
| 第二层 | 清除缓存后重启 | 反复崩溃、疑似缓存损坏 |
| 第三层 | 重启云手机实例 | 系统级卡死、ADB无响应 |
| 第四层 | 告警转人工 | 达到最大重试次数 |
三个关键参数务必配好:最大重试次数(建议3次左右)、退避间隔(如1分钟、5分钟、15分钟逐次拉长)、冷却时间(同一应用短时间内多次崩溃时先暂停并告警)。它们是防止崩溃循环的关键。
看门狗脚本示例
下面用一个Python看门狗脚本演示“进程检测+分层重启”的最小实现,适用于支持ADB调试的云手机环境:
import subprocess
import time

PACKAGE = 'com.example.app'   # 目标应用的包名
MAX_RETRY = 3                 # 最大连续重试次数
BACKOFF = [60, 300, 900]      # 退避间隔:1分钟、5分钟、15分钟

def is_alive():
    r = subprocess.run(['adb', 'shell', 'pidof', PACKAGE],
                       capture_output=True, text=True)
    return r.stdout.strip() != ''

def restart_app():
    subprocess.run(['adb', 'shell', 'am', 'force-stop', PACKAGE])
    time.sleep(3)
    subprocess.run(['adb', 'shell', 'monkey', '-p', PACKAGE,
                    '-c', 'android.intent.category.LAUNCHER', '1'])

retry = 0
while True:
    if is_alive():
        retry = 0
    else:
        if retry >= MAX_RETRY:
            print('[告警] 连续重启失败,请人工介入')
            break
        restart_app()
        time.sleep(BACKOFF[retry])
        retry += 1
    time.sleep(30)
脚本每30秒检查一次进程,发现崩溃后按退避间隔依次重试,连续3次失败就输出告警并退出。生产环境中可以把 print 换成邮件、IM等真实通知,再叠加心跳检测和UI检测,让监控更完善。
用畅畅云手机让自动化更省心
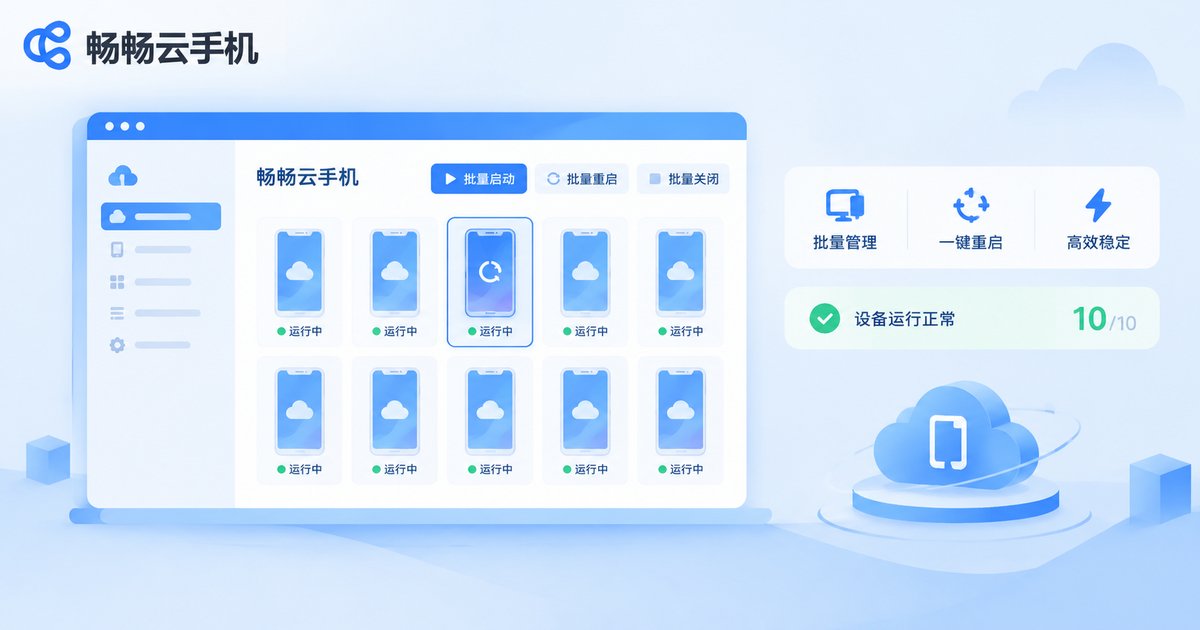
除了做好“事后补救”,稳定的运行环境能从源头减少异常。畅畅云手机(ccloudphone)提供独立云端安卓实例,全天候在线,并支持在控制台对实例进行批量管理。把它与本文的看门狗脚本结合,挂机、批量操作类任务即使长期无人值守也能稳定运行。
另一个重要建议:把监控脚本与云手机实例分开部署,例如脚本跑在本地电脑或服务器上,远程连接云手机执行检测与重启。这样即使某台实例彻底卡死,监控端依然存活,能及时发现异常并执行恢复,避免“裁判和运动员一起倒下”。
常见问题
Q:应用进程还在,但任务不动了,怎么检测?
进程存活不代表功能正常。这时要用UI元素检测或心跳检测:检查关键界面元素是否还在,或监控任务进度计数是否停滞。
Q:自动重启会不会丢失任务数据?
做好状态持久化就不会。把任务进度和关键状态实时写入文件或上报服务器,重启后从断点继续,而不是把状态只存在内存里。
Q:重试次数设多少合适?
一般3次左右,配合逐次拉长的退避间隔。次数太多会浪费资源并可能加剧问题,次数太少则容易把偶发故障当成致命故障。
Q:如何避免“崩溃—重启”死循环?
设置最大重试上限和冷却时间:同一应用短时间内反复崩溃时,先停止自动重启并告警,待人工排查后再恢复任务。


