
云手机AI自动化框架支持哪些大模型!千问Qwen3-VL集成与意图识别原理
一、云手机AI自动化框架:让大模型替你看手机、点手机
传统手机自动化脚本依赖固定坐标和录制的操作路径,有个致命弱点:界面一变,脚本就废。云手机AI自动化框架的思路完全不同——它把每一帧屏幕截图交给视觉语言大模型(VLM),让模型像人一样看懂界面,再决定下一步点哪里、输入什么。云手机在其中扮演全天候在线的云端安卓真机角色:不占用本地设备、不受本地断网息屏影响,天然适合挂机式AI自动化任务。
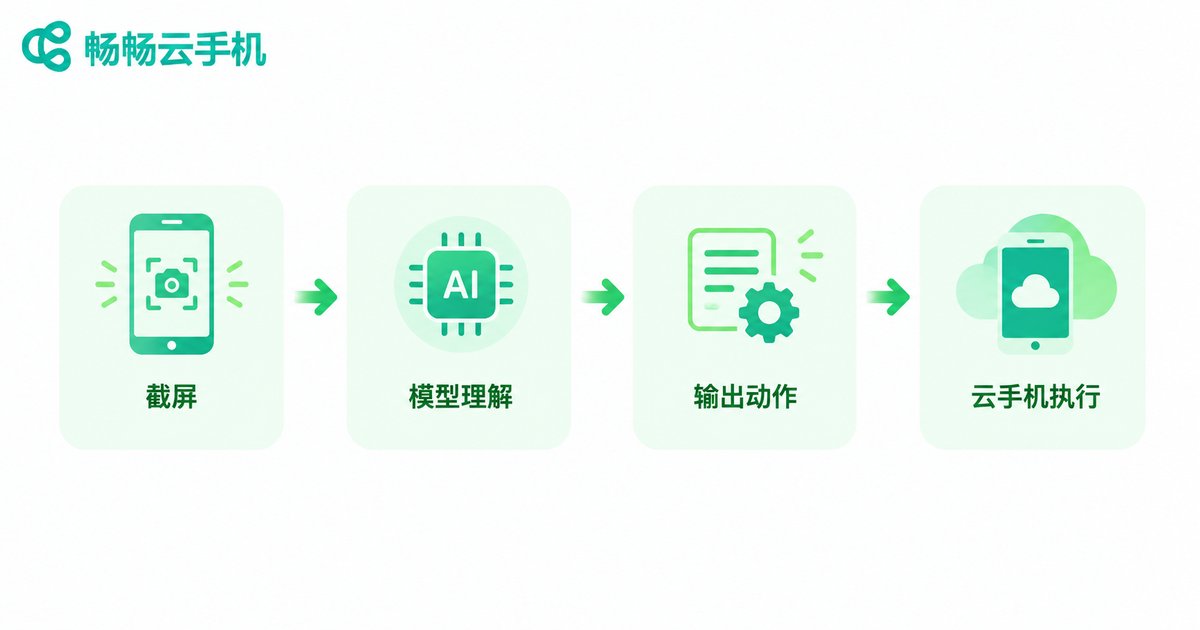
整套闭环只有四步:截屏 → 大模型理解 → 输出动作 → 云手机执行,循环往复直到任务完成。这个架构对大模型提出三个硬性要求:能看图(视觉理解)、能定位(输出元素坐标)、能守规矩(结构化输出)。这也直接决定了框架支持哪些模型。
二、框架支持哪些大模型?三类模型一张表看懂
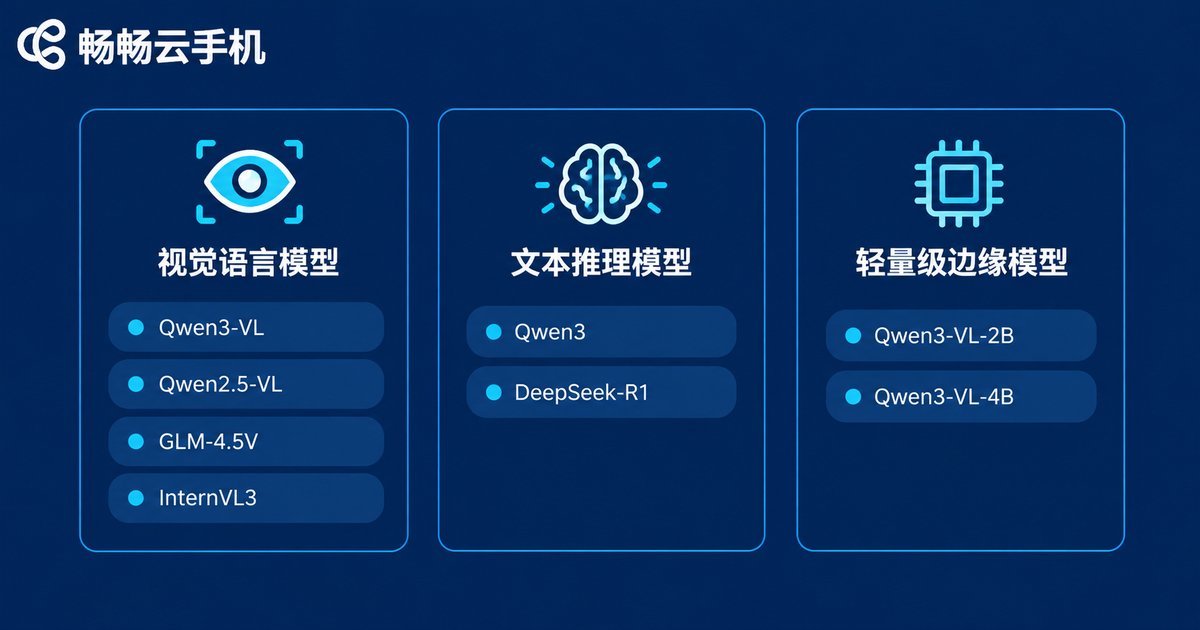
目前主流云手机AI自动化框架对大模型的支持,基本围绕三条路线展开:
| 模型类型 | 代表模型 | 在自动化中的角色 | 部署方式 |
|---|---|---|---|
| 视觉语言模型(VLM) | 千问Qwen3-VL、Qwen2.5-VL、GLM-4.5V、InternVL3 | 看懂截图、定位元素、决定点击位置 | 云端API或私有化部署 |
| 文本推理模型 | Qwen3、DeepSeek-R1、GLM系列 | 任务拆解、多步规划、意图识别 | 云端API或私有化部署 |
| 轻量端侧模型 | Qwen3-VL-2B/4B等小尺寸版本 | 低延迟的本地实时推理 | 本地GPU或边缘设备 |
其中视觉语言模型是自动化的眼睛,推理模型是大脑,两者可以组合使用:VLM负责感知,推理模型负责规划。如果任务集中在单个App内的重复操作,一个Qwen3-VL就够;如果要跨App完成复杂流程(比如“打开某应用→搜索→比价→下单”),建议VLM加推理模型双模型协作。
三、为什么千问Qwen3-VL是云手机自动化的热门选择
1. 原生GUI理解能力:Qwen3-VL针对界面截图做了专门优化,能直接输出元素的边界框坐标,点击定位不需要额外的OCR或目标检测模型,链路更短、出错更少。
2. 中文场景优势:国内App的界面文案、按钮语义和口语化指令(比如“帮我把这条视频点赞收藏”)都是中文,千问系列对中文意图的理解明显更准。
3. 尺寸齐全、部署灵活:从2B、4B的小模型到235B的大模型都有开源版本,显存紧张就跑小尺寸,追求精度就上大尺寸,也可以直接调用云端API,上手门槛很低。
4. 结构化输出稳定:自动化框架要求模型严格按JSON格式返回动作,Qwen3-VL在指令遵循和格式稳定性上表现可靠,能明显减少解析失败导致的任务中断。
四、Qwen3-VL集成实战:四步跑通从截图到动作的闭环
下面用一段Python演示最小集成流程:截取云手机屏幕 → Base64编码 → 调用Qwen3-VL → 解析动作 → 在云手机上执行。
import base64, json, requests

API = 'https://dashscope.aliyuncs.com/compatible-mode/v1/chat/completions'
KEY = '你的API-Key'

def get_action(png_path, instruction):
    img = base64.b64encode(open(png_path, 'rb').read()).decode()
    prompt = ('你是安卓自动化助手。观察截图,结合用户指令,'
              '只输出一个JSON对象,包含action(如tap/swipe/input/back)和坐标或文本字段,不要多余解释。')
    body = {
        'model': 'qwen3-vl-plus',
        'messages': [{'role': 'user', 'content': [
            {'type': 'image_url', 'image_url': {'url': 'data:image/png;base64,' + img}},
            {'type': 'text', 'text': prompt + ' 用户指令:' + instruction}
        ]}]
    }
    r = requests.post(API, json=body, headers={'Authorization': 'Bearer ' + KEY})
    return json.loads(r.json()['choices'][0]['message']['content'])

action = get_action('screen.png', '打开设置里的显示亮度')
# 解析结果形如:{'action': 'tap', 'x': 540, 'y': 1200}
# 拿到坐标后,通过ADB或云手机群控接口执行点击,然后回到第一步重新截屏,循环执行
工程化落地还要补三件事:动作执行器(把tap/swipe/input翻译成云手机可执行的指令)、循环与终止条件(任务完成或超过最大步数就停)、异常兜底(模型输出解析失败时自动重试或降级)。这三块做扎实,自动化任务才能长时间稳定挂机。
五、意图识别原理:把一句中文拆成可执行的动作序列
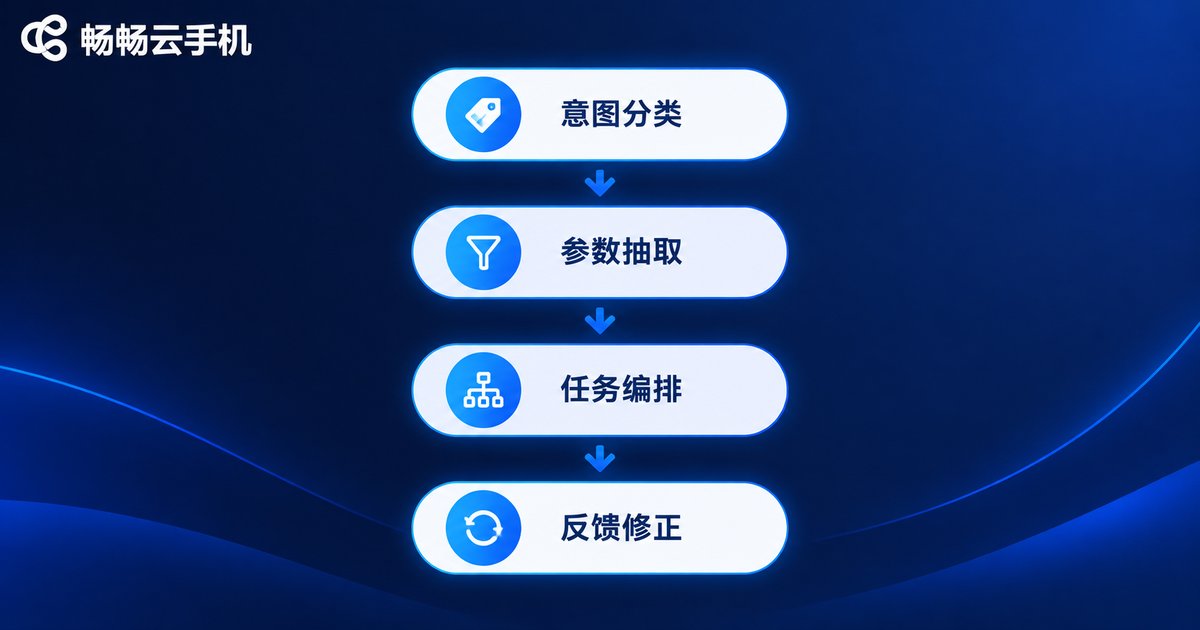
用户输入的往往是一句自然语言,比如“每天早上八点帮我签到领积分”。框架的处理流水线分四层:
第1层 意图分类:先判断这句话属于哪类任务——签到、发布内容、数据采集还是消息回复。通常用提示词让模型输出固定的意图标签,配合少样本示例,准确率可以做到很高。
第2层 参数抽取:把时间、对象、次数等关键信息填进模板。“每天早上八点”对应定时执行的cron表达式,“签到领积分”对应目标App和页面路径。
第3层 任务编排:把意图加参数展开成动作序列,形成“启动App→定位签到按钮→点击→截图确认→关闭App”这样的执行计划;复杂任务会进一步拆成带分支和重试的状态机。
第4层 反馈修正:每执行一步,都把新截图回传给模型判断“操作是否生效”。弹出了广告就先关广告,按钮没找到就滑动再找一圈——正是这个闭环,让AI自动化的抗变化能力远超传统脚本。
一个实用的意图识别提示词骨架长这样:
system_prompt = '''你是手机任务规划器。可选意图:sign_in(签到)、post(发布)、collect(采集)、reply(回复)。
请先输出intent,再输出params(含app、time、target等字段),最后输出steps动作列表。
信息不足时输出intent为clarify,并说明需要用户补充什么。'''
六、在畅畅云手机上落地:稳定环境是AI自动化的地基
再聪明的模型,也需要一台永远在线、状态干净的手机来执行动作。畅畅云手机(ccloudphone)提供云端安卓真机环境,支持多台云手机并行运行,本地电脑关机也不影响任务执行。配合上面这套AI自动化框架,就能实现全天候挂机:模型负责规划,云手机负责执行,你只看结果。多开场景下,还可以让多台云手机跑同一套意图识别流程,横向扩大任务吞吐量。环境配置和接入方式,可以到畅畅云手机官网(ccloudphone)进一步了解。
常见问题 Q&A
Q:完全不会写代码,能用云手机AI自动化吗?
可以。不少自动化框架已经做成低代码或对话式配置——用中文描述任务,框架自动完成意图识别和动作编排。需要动手写代码的,主要是想深度定制执行器的高级玩家。
Q:Qwen3-VL一定要自己买显卡部署吗?
不一定。小尺寸开源版本可以本地部署,也可以直接调用官方API按量付费。个人自动化任务调用量不大,API方式成本很低;企业级大规模并发才需要考虑私有化部署。
Q:意图识别总是理解错需求怎么办?
三招:一是在提示词里补充业务场景的少样本示例;二是把模糊指令拆具体,比如把“帮我处理一下”改成“打开XX App签到”;三是开启clarify反问机制,让模型在信息不足时主动追问,而不是靠猜。
Q:云手机跑AI自动化,和真机群控相比优势在哪?
云手机不依赖实体设备,支持多开和集中管理,本地电脑关机任务照跑,环境可以随时重置,适合长期挂机型任务;真机群控则在需要实体SIM卡和传感器的场景不可替代。按业务需求选择即可。
Q:一套框架能同时接多个大模型吗?
可以,而且推荐这么做。常见做法是感知用Qwen3-VL这类视觉语言模型,规划和意图识别交给推理模型;简单任务走小模型省成本,复杂任务自动切换大模型,按任务难度动态路由。


